 Rendre votre entreprise lisible par l’IA. Dehors, et dedans.
Relevé publié · Méthode de mesure
L’application ChatGPT et notre instrument rendent le même verdict, 30 sur 30.
Nos diagnostics mesurent ChatGPT avec un instrument automatisé et rejouable. La question légitime est : est-ce bien ce que voit un utilisateur réel de l’application ? Dans la nuit du 14 au 15 août 2026, nous avons posé les 30 questions figées du diagnostic Real French sur les deux surfaces, la même nuit, et comparé les verdicts. Ils sont identiques. Le mot juste est concordance, pas corrélation : nous comparons deux surfaces question par question et nous comptons les accords.
Ce qui a été comparé
D’un côté, un humain dans l’application ChatGPT, sur chatgpt.com : compte payant, modèle GPT-5.6 Sol, effort de raisonnement Medium, un chat éphémère par question, question collée sans reformulation, adresse IP française, une capture d’écran par réponse. De l’autre, le Banc de mesure HENUSSE, notre outil de relevé, construit par la maison autour des agents publiés par les éditeurs eux-mêmes plutôt qu’autour d’un tableau de bord tiers revendu, à l’identique des diagnostics : Codex, l’agent d’OpenAI distribué dans le produit ChatGPT lui-même, piloté en ligne de commande avec sa recherche web native, trois passes complètes sur les 30 questions, 90 réponses conservées avec leurs sources. Quand ChatGPT cherche-t-il vraiment sur le web ?
Le barème
Pour chaque question, chaque surface reçoit le même verdict que dans le diagnostic : Real French citée dans les sources, mentionnée dans le texte, ou absente. Le même relecteur a scoré les deux surfaces, avec le même barème, à partir des captures et des réponses brutes.
Le résultat, chiffré
| Règle de comparaison | Accord |
|---|---|
| Verdict majoritaire des trois passes de l’instrument, contre la passe de l’application | 30 sur 30 (100 %) |
| Règle la plus sévère : une seule passe de l’instrument suffit à compter une présence | 29 sur 30 (96,7 %) |
L’unique divergence de la règle sévère est la question 19, « best way for an adult to finally speak French confidently » : l’instrument a mentionné Real French dans le texte d’une passe sur trois, jamais dans les sources, et l’application ne l’a pas mentionnée. C’est exactement la variation d’échantillonnage qui justifie nos trois passes.
Sur ce jeu de questions, les deux surfaces disent la même chose : Real French est absente des réponses. Le relevé du diagnostic public, effectué du 7 au 8 août 2026, comptait 6 présences sur 270 réponses toutes surfaces confondues. Ce contrôle en valide la part OpenAI : pour ChatGPT, le relevé décrit bien ce que constate un utilisateur réel. Les parts Claude et Gemini restent à contrôler de la même façon.
Une étude complémentaire répond désormais à la question suivante : une marque est-elle citée de la même façon selon la surface interrogée ? Elle compare le même jeu figé sur les API, les applications et les aperçus IA de Google, puis publie chaque règle de lecture.
{“@context”:”https://schema.org”,”@type”:”WebPage”,”@id”:”https://henusse.com/reference-ia/diagnostic/etude-correlation/#webpage”,”mentions”:{“@id”:”https://henusse.com/reference-ia/diagnostic/etude-multi-surfaces/#webpage”}}Deux observations utiles
L’application ne cherche pas toujours
Sur les 30 questions, l’application n’a déclenché sa recherche web que sur 11 : les dix questions d’achat, celles où l’on compare des programmes, et la question sur l’oral du DELF. Sur les 19 questions de conseil, elle répond de mémoire, sans citer aucune source : personne n’y est cité, ni Real French ni un concurrent. Sur ce jeu de questions, les questions commercialement décisives sont précisément celles où l’application cherche et cite.
Le même terrain des deux côtés
Quand les deux surfaces cherchent, elles citent la même population de sites : instituts d’immersion, écoles résidentielles, plateformes de séjours linguistiques. Nous n’avons pas comparé les URL une à une et nous n’affirmons pas que la couche de récupération soit la même, faute de documentation publique : ce que nous observons, c’est un même terrain de sites candidats. C’est ce terrain que le travail de citabilité vise, et c’est pourquoi une amélioration mesurée par l’instrument a vocation à se retrouver dans l’application.
Limites
Une seule passe d’application par question, sur un seul compte, une seule nuit : une réponse d’application est une distribution, mémoire, localisation et tests compris, et nous en avons prélevé un point par question. Le verdict porte sur la présence de la marque, pas sur la formulation des réponses, qui diffère entre surfaces. Ce relevé vaut pour ce site, ce jeu de questions et cette date ; il sera rejoué chaque trimestre, mêmes questions, même barème, écarts publiés, zéros compris.
Ce que ce relevé ne démontre pas
Real French étant absente presque partout, ce relevé teste surtout que l’instrument n’invente pas de visibilité ; il teste moins bien sa capacité à détecter une marque réellement citée. Les trois passes sont justifiées empiriquement par la divergence de la question 19, mais leur nombre n’est pas encore démontré optimal. Le relevé de novembre 2026 répondra aux deux : un panel de marques témoins couvrant tout l’éventail, des toujours citées aux absentes, avec sensibilité et spécificité chiffrées. Au sens statistique, ce relevé est d’ailleurs une étude de concordance, pas une corrélation : tous les verdicts tombant dans la même classe, un coefficient d’accord comme le kappa de Cohen n’y est même pas définissable. Il le devient sur un panel contrasté ; celui de novembre le publiera. Enfin, ce contrôle ne couvre que la surface OpenAI : les instruments Claude et Gemini restent à contrôler de la même façon.
L’instrument a changé le 16 août 2026
Depuis le 16 août 2026, la sonde interroge gpt-5.6-sol, le modèle servi aux abonnés payants de ChatGPT, afin de mesurer ce que reçoit un client réel. Le contrôle publié sur cette page a comparé la version précédente, gpt-5.5, à l’application, le 15 août 2026 : il reste vrai pour cette configuration, et il ne décrit plus celle en service. La concordance du couple actuel sera établie au relevé de novembre 2026.
Changement du 24 août 2026 : le bras Claude de la sonde passe d’Opus (le modèle des relevés publiés jusqu’au 24 août) à Sonnet, le modèle réellement servi à la plupart des utilisateurs de Claude. Le modèle exact reste nommé sur chaque relevé, et l’ancien bras Opus est conservé en comparaison.
Une étude anglophone conclut l’inverse : ce que nous répondons
La société parisienne H Company a publié une comparaison entre l’interface de programmation d’OpenAI et l’application web de ChatGPT, sur des requêtes d’achat : Learning From the User. Elle mesure environ 18 % de recouvrement sur les produits recommandés et environ 2,5 % sur les citations, et conclut que les deux surfaces se comportent comme deux moteurs de recherche différents. Sa page porte la date du 27 février 2026. Nous la citons parce qu’elle a raison sur son terrain, et parce qu’un lecteur qui la trouvera après nous doit savoir que nous l’avions lue.
Les deux résultats sont vrais ensemble, parce qu’ils ne portent pas sur le même objet. H Company mesure quels produits et quelles sources apparaissent, ce qui est une mesure fine et très sensible aux écarts. Notre relevé mesure un verdict binaire de présence, sur une marque absente presque partout : c’est une mesure grossière, et le paragraphe ci-dessus l’écrit déjà. Elle prouve que l’instrument n’invente pas de visibilité, elle ne prouve pas encore qu’il voit la même chose que votre client quand une marque est réellement citée. C’est exactement ce que le panel de marques témoins de novembre 2026 doit établir.
Les preuves
Le relevé s’appuie sur 30 captures d’écran horodatées, une par question ; sur les 90 réponses brutes de l’instrument avec leurs URL sources ; et sur la grille de scorage complète. Deux captures sont publiées ci-dessous ; l’ensemble est conservé, daté, et remis sur demande, comme le prévoit la charte de mesure.
Conditions exactes du relevé
Côté instrument : codex-cli version 0.142.5, modèle gpt-5.5, exécution non interactive avec l’outil de recherche web natif d’OpenAI activé, une session neuve par passe, sans historique, sans personnalisation ni saisie en cours de réponse, adresse IP française, trois passes par question dans la même nuit que les captures. Côté application : les conditions décrites en tête de page, capturées question par question. Rien de tout cela n’est un secret de méthode : ce sont les conditions à connaître pour rejouer le relevé.
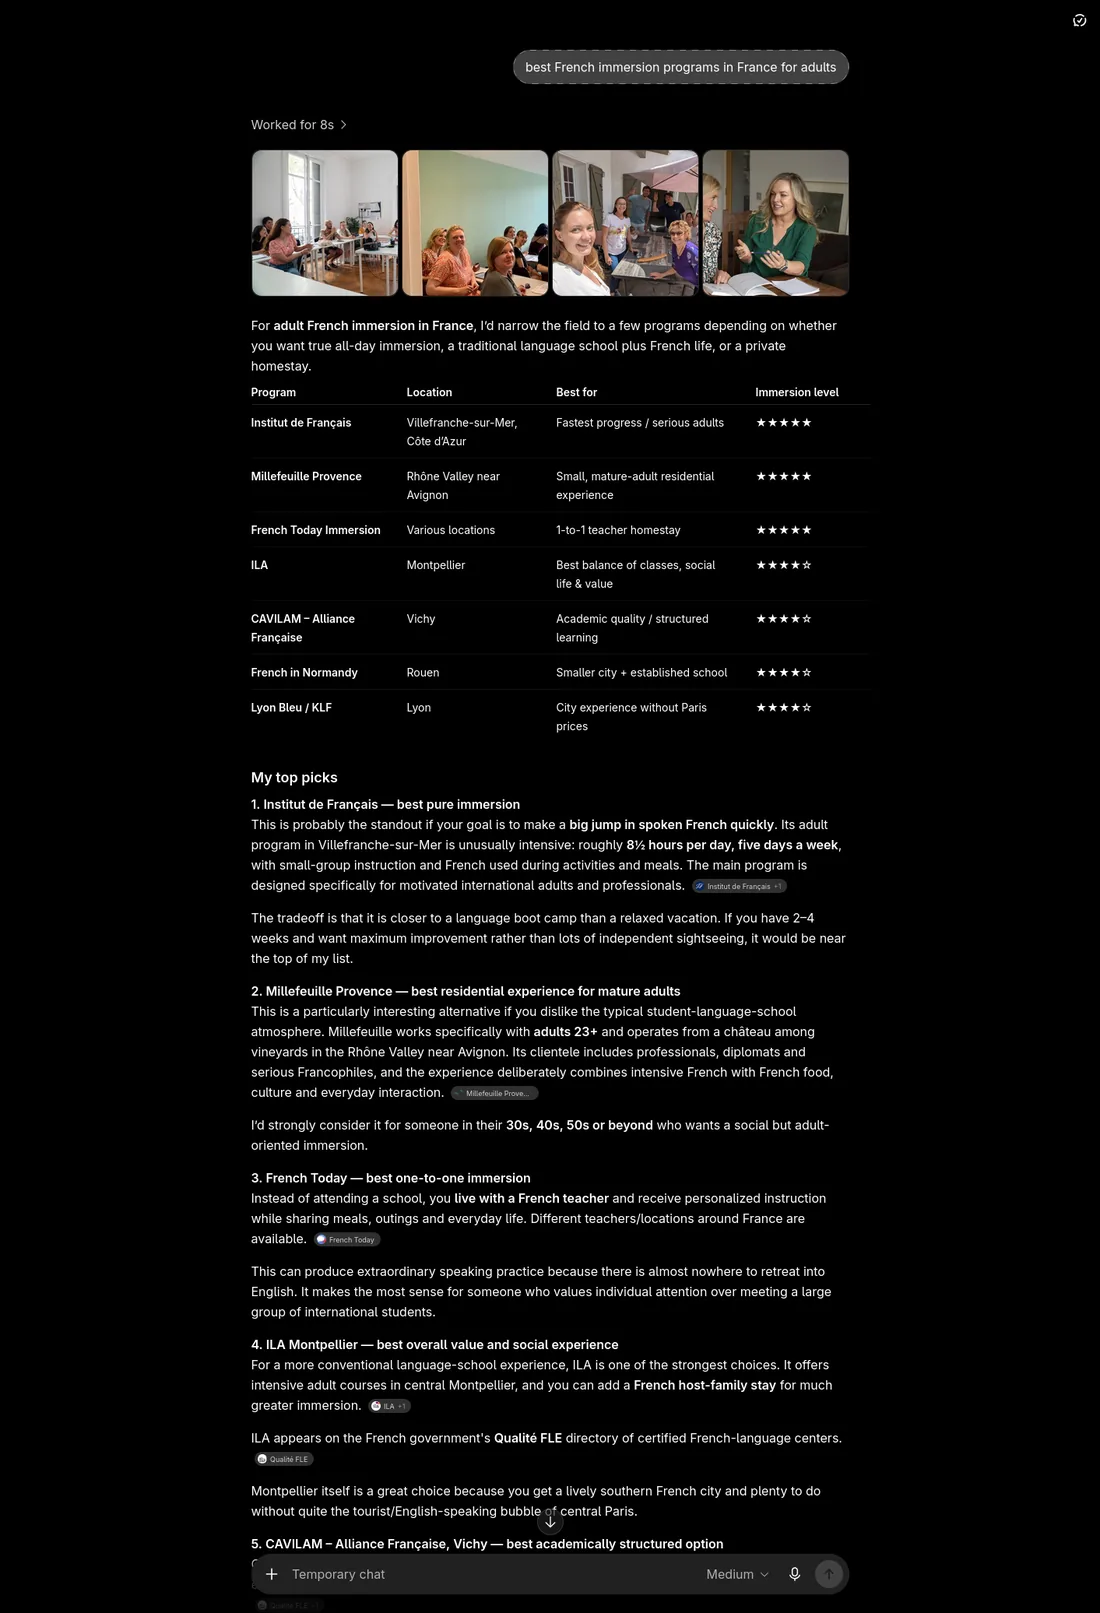
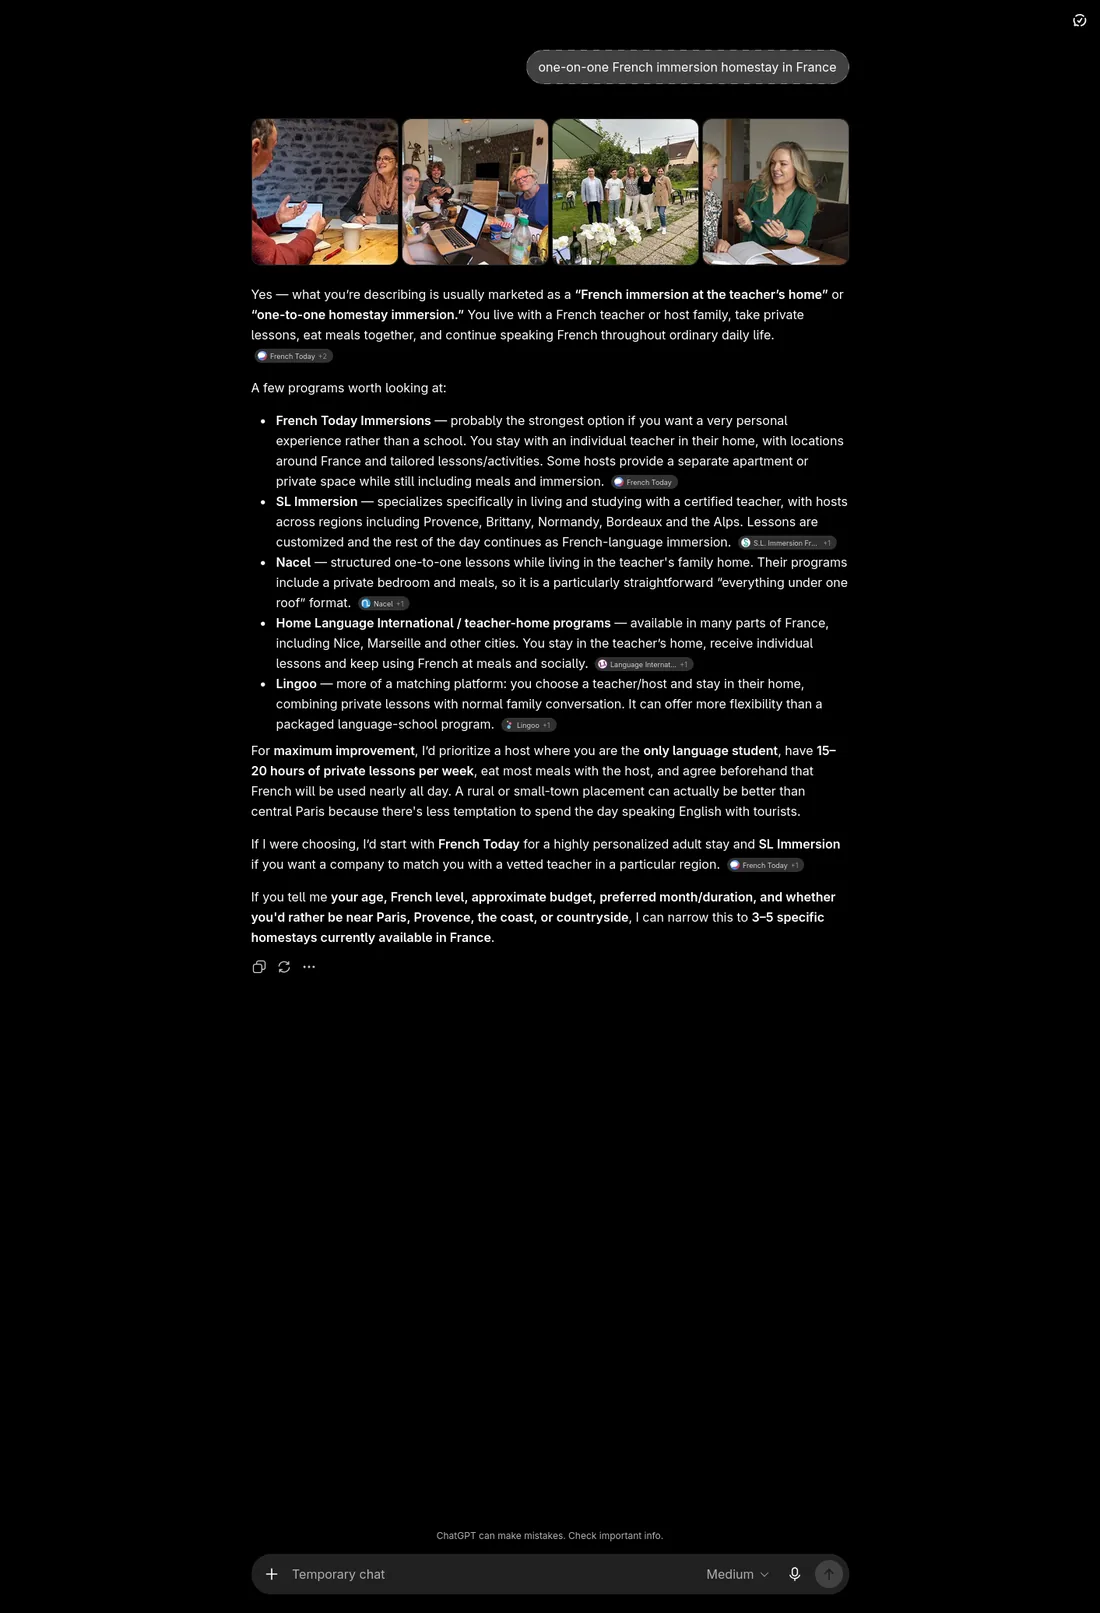
Cette même question 2 porte une leçon de plus : au diagnostic du 7 août, une semaine plus tôt, l’instrument y avait cité Real French sur ses trois passes, en positions 3, 6 et 7 des sources ; au relevé du 14, plus aucune surface ne la cite. Une citation peut donc apparaître et disparaître en une semaine. C’est exactement pourquoi chaque relevé est daté, pourquoi un score est une photographie et non un acquis, et pourquoi la seule mesure qui informe est celle qui se répète.
Ce que ce relevé ferme comme questions
Mesurez-vous le vrai ChatGPT que voient mes clients ?
Oui, et c’est vérifié plutôt qu’affirmé : au relevé de la nuit du 14 au 15 août 2026, l’application ChatGPT et notre instrument rendent le même verdict de présence sur 30 questions sur 30. La méthode, la divergence unique et les limites sont publiées sur cette page, captures à l’appui.
Pourquoi mesurer avec un instrument plutôt qu’avec l’application ?
Parce qu’une réponse de l’application dépend du compte qui pose la question : mémoire, historique, localisation, tests en cours. L’instrument est rejouable à l’identique, en session neutre, trois fois par question ; n’importe qui peut refaire le test dans les mêmes conditions et vérifier nos comptes à la date du relevé. Les réponses, elles, bougent : Real French était citée le 7 août sur la question 2 et ne l’était plus le 14. Un relevé est une photographie datée, pas un acquis. Aucun éditeur ne documente publiquement si la recherche de l’outil en ligne de commande et celle de l’application partagent la même infrastructure : plutôt que d’en débattre, nous avons mesuré le résultat, et il est identique, 30 sur 30. C’est ce que cette étude vérifie, trimestre après trimestre, au lieu de le supposer.
Et si un écart apparaissait un trimestre ?
Il serait publié ici, chiffré, et l’instrument serait ajusté. C’est la règle de toute notre mesure : les questions sont figées avant le test, les fractions sont datées, et un zéro s’écrit zéro.
Relevé réalisé dans la nuit du 14 au 15 août 2026. Questions figées le 7 août 2026 lors du diagnostic public Real French. Les 30 questions sont hors-marque : aucune ne contient le nom du client. Prochain relevé : novembre 2026, étendu à un panel de marques témoins.